

- Что тормозит выгрузку товаров на сайт
- Убираем из процесса тысячи однотипных решений в день
- Как сервис определяет правильную ветку каталога
- Данные не покидают контур компании
- Экономим 1300 часов и полмиллиона в год
Товар приехал на склад в понедельник, а на сайте появился только через две недели. Всё это время он не участвовал в онлайн-продажах: покупатели его не видели, компания теряла потенциальную выручку, а деньги были заморожены в товарном запасе. Это знакомо многим компаниям, которые быстро расширяют ассортимент. Пока поток новинок небольшой, контент-менеджеры справляются, но когда объём поступлений вырастает в несколько раз за короткий срок, вывод товаров на сайт замедляется.
Подобные задержки нередко возникают и у дистрибьюторов, чей ассортимент пополняется позициями из прайс-листов множества поставщиков. Позиции партнеров нужно правильно завести в существующий каталог на сайте, определив для них подходящие категории. Чем больше поставщиков и товаров, тем больше времени занимает такая обработка вручную.
В похожей ситуации оказался наш заказчик, который продаёт спецтехнику, промышленное оборудование, запчасти и комплектующие. Компания стала развивать свою площадку, подключая партнеров и пополняя свой каталог их позициями — поток товаров резко вырос в несколько раз. Остро встал вопрос: как сохранить скорость вывода новинок на сайт, не нанимая больше людей?
Что тормозит выгрузку товаров на сайт
Каталог компании, как у большинства интернет-магазинов, имеет древовидную структуру. Для нового товара нужно определить всю цепочку разделов вплоть до конкретной категории.
Пример: датчик давления масла должен находиться в ветке «Запасные части и комплектующие → Электрическое и электронное оборудование → Датчики и переключатели».
Чтобы правильно присвоить товару категорию, контент-менеджеру нужно:
-
его изучить — хотя бы прочитать и понять название;
-
хорошо ориентироваться в структуре каталога.
В среднем операция занимает 20 секунд — кажется, немного. Но когда ежедневно менеджер обрабатывает 1000 новых позиций, эта рутинная работа «съедает» 5–6 часов. А ведь ещё нужно подготовить описания и заполнить характеристики для каждого товара перед импортом файла в CMS.
Убираем из процесса тысячи однотипных решений в день
После перехода к бизнес-модели маркетплейса компания могла:
-
нанять больше контентщиков, чтобы поддерживать скорость вывода на сайт;
-
смириться с очередью и медленной публикацией;
-
автоматизировать процесс категоризации новинок.
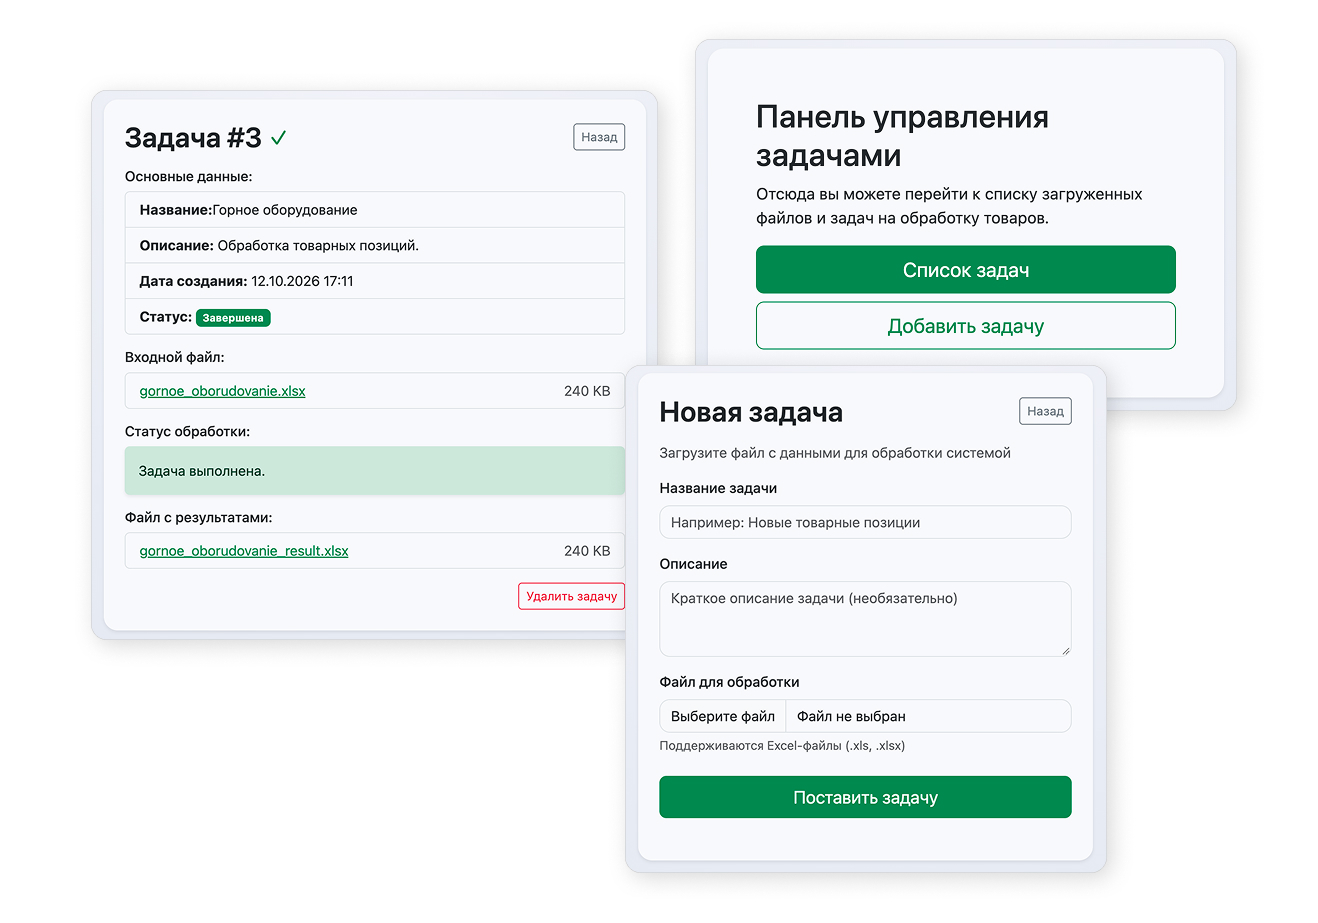
Заказчик выбрал третий путь. В результате это позволило свести работу менеджера в части категоризации новинок к простому алгоритму:
-
Открыть сайт специализированного сервиса.
-
Загрузить таблицу с наименованиями новых товаров.
-
После окончания обработки скачать готовый файл.
В нём — исходный список товаров, рекомендуемая ветка существующего каталога напротив каждой позиции и оценка уверенности в рекомендации. Сотруднику нужно только проверить спорные результаты обработки, чтобы подтвердить или скорректировать классификацию.
Так создание карточки товара ускоряется: сотруднику не нужно решать, куда отнести очередную позицию, — достаточно проставить в полях «админки» назначенные категории.
Как сервис определяет правильную ветку каталога
Сервис понимает, куда положить новый товар именно в каталоге компании, с помощью искусственного интеллекта. Но в чём отличие от обычного чата с нейросетью? Если отправить в него список товаров и попросить разложить их по каталогу, то в ответе будут, скорее всего, выдуманные категории. Детальное описание существующего каталога в промпте может улучшить качество ответа, но вероятность ошибки всё равно высока.
Чтобы ответы нашего ИИ-сервиса были достоверными и «заточенными» под компанию, обработку запросов к нему разделили на два этапа.
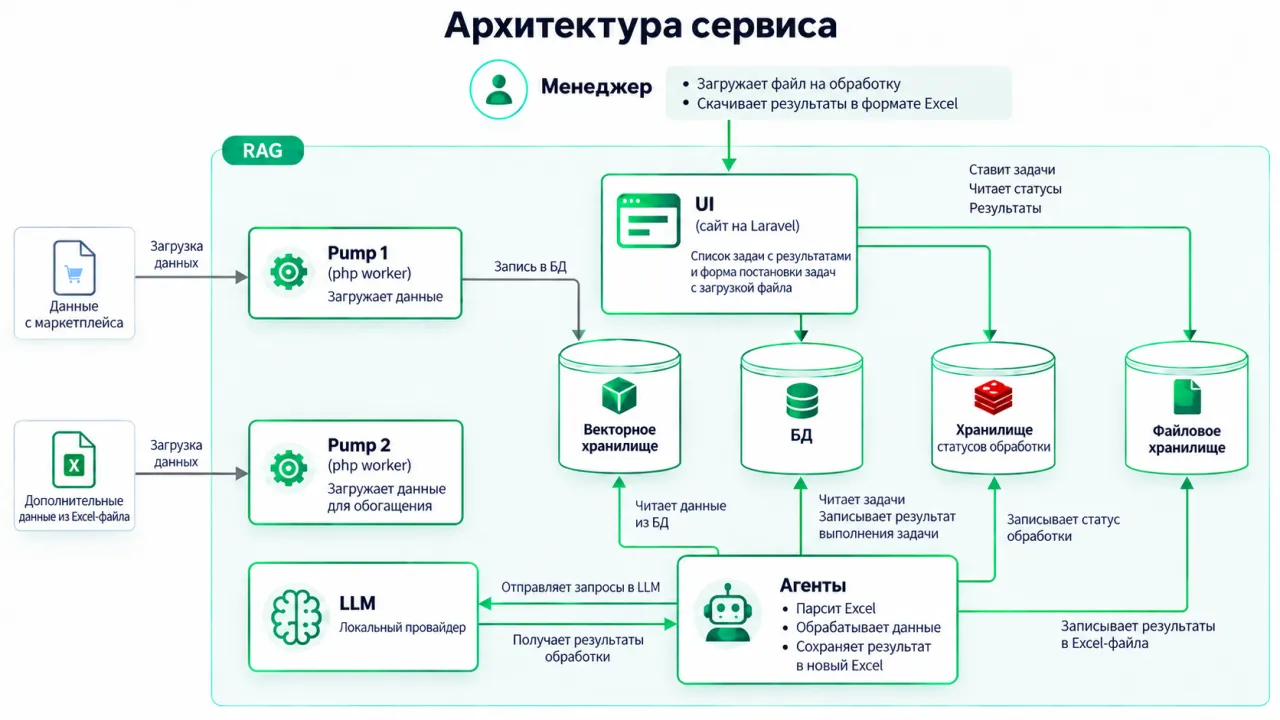
Сначала система разбирает Excel-таблицу со списком новинок и ищет похожие товары в реальном каталоге. При этом ИИ не ходит в интернет и не сканирует сайт каждый раз. Это сделано единожды: собрали все данные каталога, преобразовали в числовые представления смысла текста — эмбеддинги — и загрузили в векторную базу. Текст каждой загруженной таблицы новинок LLM тоже преобразует в эмбеддинги.
Преобразование в числовые представления позволяет искать совпадения новинок с опубликованными товарами по смыслу, а не по буквальному названию. Например, «датчик» и «сенсор» — формально разные слова, но означают одно и то же, и товары будут находиться в одной ветке каталога.
На втором этапе обработки подключается вторая языковая модель. Система передаёт ей несколько источников контекста:
-
исходные данные нового товара;
-
найденные похожие товары;
-
категории, к которым они относятся;
-
актуальное дерево разделов каталога компании — для обогащения данных можно подключить ещё каталог конкурентов.
На основе полученной информации LLM предлагает для каждой новинки три подходящие ветки каталога, оценивает свои предложения и выбирает лучший вариант. Затем проверяет качество собственного решения, чтобы сократить риск ошибочной классификации. В итоговой таблице контент-менеджер видит напротив товара, насколько надёжен ответ ИИ по нему. Там, где нужна перепроверка человеком, для удобства подсвечено желтым.
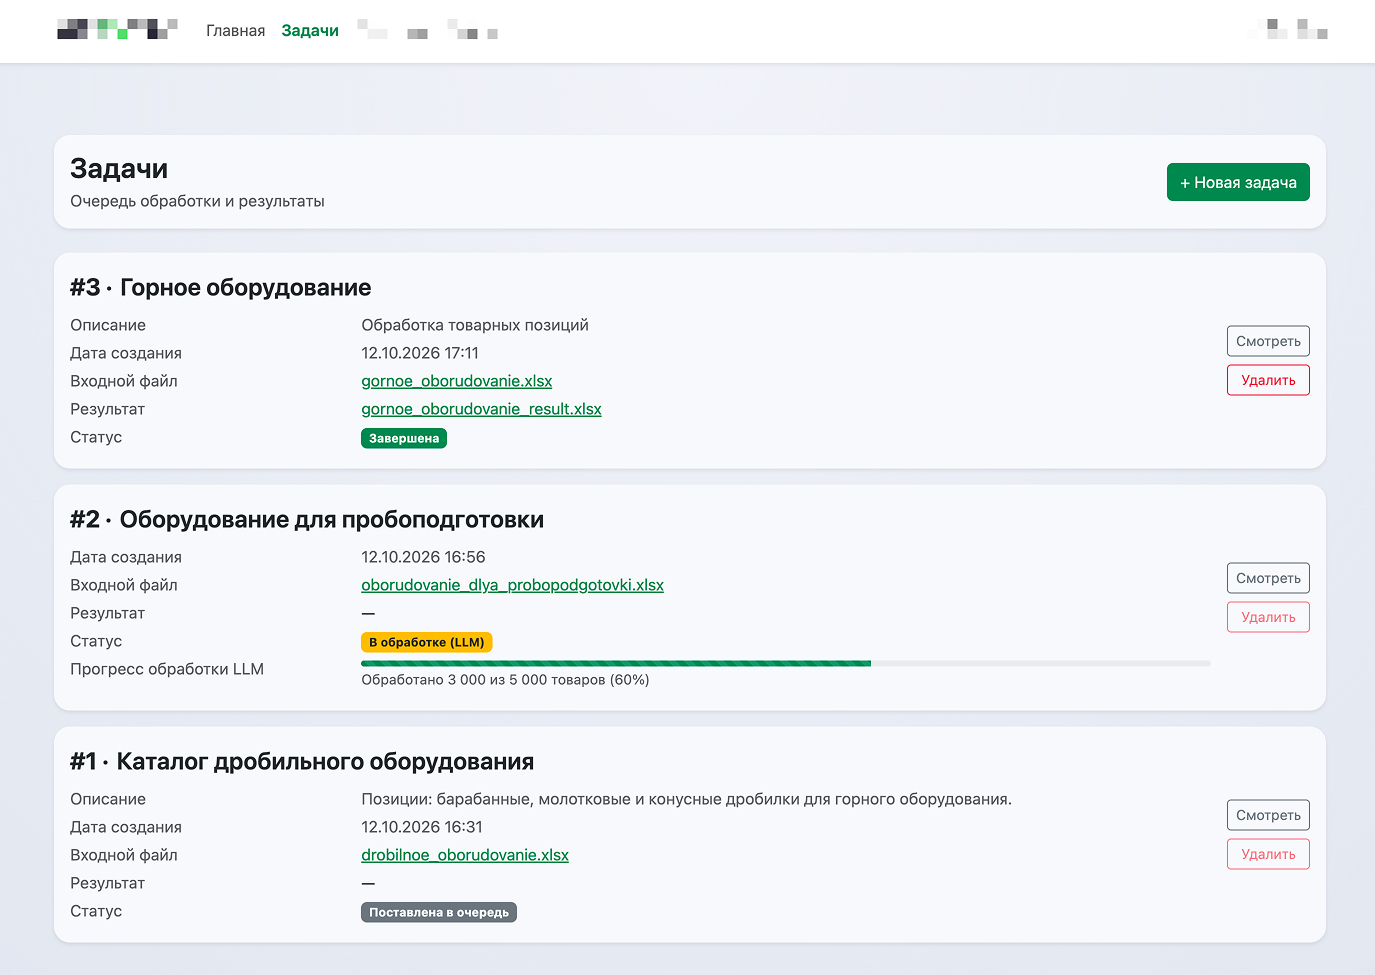
Для контент-менеджера весь алгоритм работы сервиса остаётся «под капотом». Он только загружает Excel-файл и обратно получает готовую таблицу — никаких промптов не нужно. Можно загрузить несколько документов друг за другом: для каждого сервис формирует отдельную задачу. Пользователю виден её статус — в очереди, в обработке или завершена — и прогресс выполнения.


Данные не покидают контур компании
Сервис работает с чувствительными данными: списками новых поступлений, сведениями о существующих товарах, структурой каталога. Чтобы обезопасить информацию, систему полностью развернули локально на выделенном сервере. Сайт, базы данных, хранилища, очередь задач и обе языковые модели работают в закрытом контуре.
Такая архитектура отвечает требованиям бизнеса, который не готов передавать внутреннюю информацию во внешние AI-сервисы. Компания полностью контролирует, где находятся корпоративные данные и какие системы получают к ним доступ.
Второй плюс локального развёртывания — нет зависимости от стороннего ИИ-сервиса. Работа сервиса не привязана к его доступности, API, лимитам или изменению условий использования.
Экономим 1300 часов и полмиллиона в год
Стабильность работы не пустой звук для сервиса, который рассчитан на обработку постоянного потока новых позиций: ежедневно через него проходит несколько тысяч товаров. На обработку одной таблицы с 1000 строк у системы уходит около 30 минут — это почти в 10 раз быстрее, чем категоризация вручную.
С математической точки зрения у контент-менеджера высвобождается 5–6 часов рабочего времени, которое он тратил на определение категории тысячи товаров — это ~500 тысяч рублей ФОТ ежегодно с учётом средней зарплаты специалиста в России.
На практике новые товары стали быстрее появляться на сайте после поступления. Процесс размещения ускорился: пока сервис обрабатывает таблицу, сотрудник заполняет и публикует карточки уже классифицированных товаров. Да, человеку всё ещё приходится уделять внимание отдельным позициям, по которым система не смогла принять точное решение. Но основной массив проходит категоризацию без ручного поиска по дереву каталога.
Сейчас сервис работает как MVP и решает одну конкретную задачу — автоматическая категоризация товаров. На следующем этапе его можно развивать дальше: например, «научить» генерировать для классифицированных товаров короткие описания, а после модерации — создавать заполненные карточки на сайте.
Если у вас есть процесс, который тормозит рост, съедает слишком много времени команды или требует всё больше ресурсов, расскажите нам о нём. Наши эксперты разберутся, где возникает узкое место, определят причины и предложат решение — с внедрением искусственного интеллекта или без него. Заполните форму ниже, чтобы менеджер связался с вами и организовал онлайн-встречу с командой.
Статьи по теме